Bądź na bieżąco - RSS

Kopia zapasowa Vaultwarden: eksport Bitwarden CLI do szyfrowanego 7z
31 października, 2026 | Brak Komentarzy | Kategoria: Linux, Porady

Kopia zapasowa Vaultwarden - skrypt bw i szyfrowane archiwum 7z w terminalu

Kopia zapasowa Vaultwarden robiona ręcznie wyglądała u mnie zawsze tak samo. W każdą sobotę logowałem się do sejfu w przeglądarce, eksportowałem dwa pliki CSV i pakowałem je do archiwum 7z z hasłem. To działa, ale tylko wtedy, gdy o tym pamiętasz. Dlatego przeniosłem cały proces do terminala.

Poniżej opisuję rozwiązanie, którego używam w domowej sieci. Bitwarden CLI eksportuje sejf osobisty i organizację, a krótki skrypt pakuje oba pliki do zaszyfrowanego archiwum. Ten sam skrypt uruchomisz na Linuksie i na macOS.

Stan informacji i wersji: 31 października 2026 r. Bitwarden CLI 2026.10.0, Ubuntu 22.04 oraz macOS z Homebrew.

W skrócie: najpierw bw sync, potem bw export dla sejfu osobistego i organizacji, na końcu 7z z hasłem wpisywanym z klawiatury i zaszyfrowaną listą plików. Pliki CSV znikają zaraz po spakowaniu.

W artykule:

  1. Punkt wyjścia: ręczny eksport co tydzień
  2. Instalacja Bitwarden CLI i pułapka z npm
  3. Konfiguracja i pierwszy eksport
  4. Skrypt do szyfrowanego 7z
  5. Ten sam skrypt na macOS
  6. Czego nie zawiera eksport CSV
  7. Najczęstsze pytania

Kopia zapasowa Vaultwarden: punkt wyjścia

Na serwerze Vaultwarden trzymam dwa zbiory haseł: sejf osobisty oraz organizację współdzieloną z zespołem. W panelu webowym oba wybieram z listy źródeł eksportu. Sejf osobisty widnieje tam jako „My vault”, a organizacja pod własną nazwą.

Każdy eksport trafia do osobnego pliku CSV. Następnie oba pliki pakuję do archiwum 7z z hasłem. Nazwa archiwum zawiera datę w formacie RR_MM_DD:

26_09_26_VW.7z
26_10_03_VW.7z
26_10_10_VW.7z
26_10_17_VW.7z

Ten układ chciałem zachować. Zmienić miał się tylko sposób tworzenia kopii: zamiast kilkunastu kliknięć jedno polecenie.

Instalacja Bitwarden CLI

Vaultwarden implementuje API Bitwardena. Dzięki temu współpracuje z oficjalnymi klientami, w tym z narzędziem wiersza poleceń bw. Eksport odbywa się po stronie klienta. CLI pobiera zaszyfrowany sejf i odszyfrowuje go lokalnie, więc otwarte dane nie przechodzą przez sieć.

Pułapka, na której się przejechałem: npm i stary Node.js

Pierwszy odruch to instalacja przez npm. Na Ubuntu 22.04 kończy się ona jednak serią ostrzeżeń i błędem:

$ npm install -g @bitwarden/cli
npm WARN EBADENGINE Unsupported engine {
npm WARN EBADENGINE   package: '@bitwarden/cli@2026.10.0',
npm WARN EBADENGINE   required: { npm: '>=10', node: '>=22' },
npm WARN EBADENGINE   current: { node: 'v12.22.9', npm: '8.5.1' }
...
npm ERR! code EACCES
npm ERR! path /usr/local/lib/node_modules

Widać tu dwa niezależne problemy. Błąd EACCES wynika z instalacji globalnej bez uprawnień roota. Ważniejsze są jednak ostrzeżenia EBADENGINE. Aktualne wydanie CLI wymaga Node.js 22, a Ubuntu 22.04 dostarcza wersję 12. Dlatego sudo niczego tu nie naprawi.

Zamiast aktualizować Node.js, wybrałem natywną binarkę. Jest samodzielna i nie potrzebuje żadnego środowiska uruchomieniowego:

cd /tmp
wget -O bw.zip \
  "https://vault.bitwarden.com/download/?app=cli&platform=linux"
unzip bw.zip
sudo install -m 755 bw /usr/local/bin/bw
bw --version

Bez uprawnień administratora skopiuj plik do ~/.local/bin. Po ponownym zalogowaniu Ubuntu doda ten katalog do zmiennej PATH.

Nieudana instalacja npm nie zostawia nic w katalogach systemowych. W katalogu domowym zostają jedynie cache i logi:

rm -rf ~/.npm

Jeżeli Node.js był potrzebny tylko do tego celu, usuń go razem z zależnościami. Przed potwierdzeniem przejrzyj listę pakietów, którą pokaże apt:

sudo apt purge nodejs npm
sudo apt autoremove --purge

Konfiguracja Bitwarden CLI dla Vaultwarden

Krok 1: adres serwera

bw config server https://vault.twoja-domena.pl

Jeśli serwer używa certyfikatu z własnego CA, wskaż plik tego CA w zmiennej NODE_EXTRA_CA_CERTS. Zrób to przed pierwszym połączeniem.

Krok 2: logowanie kluczem API

Logowanie nazwą użytkownika i hasłem działa, ale przy włączonym 2FA wymaga kodu. Z tego powodu wybrałem klucz API konta. Znajdziesz go w panelu webowym: Ustawienia konta → Bezpieczeństwo → Klucze → Wyświetl klucz API.

bw login --apikey

Polecenie zapyta o client_id i client_secret. Klucz API loguje jednak tylko do konta. Do odszyfrowania sejfu nadal potrzebne jest hasło główne.

Krok 3: odblokowanie sejfu i identyfikator organizacji

export BW_SESSION=$(bw unlock --raw)
bw list organizations --pretty

Pierwsze polecenie pyta o hasło główne i zapisuje klucz sesji w zmiennej. Drugie wyświetla organizacje. Zanotuj wartość pola id właściwej organizacji.

Krok 4: testowy eksport

bw export --format csv --output osobisty.csv
bw export --organizationid TU_WSTAW_ID_ORGANIZACJI \
  --format csv --output organizacja.csv

Pierwsze polecenie eksportuje wyłącznie sejf osobisty. Dane organizacji wymagają osobnego eksportu z parametrem --organizationid. Oba pliki zawierają hasła otwartym tekstem, więc po teście usuń je poleceniem shred -u.

Skrypt: kopia zapasowa Vaultwarden do szyfrowanego 7z

Skrypt umieszczam w katalogu z kopiami. Uruchamiam go ręcznie, ponieważ pyta o dwa hasła: główne do sejfu oraz hasło archiwum. Żadnego z nich nie przechowuję na dysku. Przed użyciem wpisz identyfikator swojej organizacji w zmiennej ORG_ID.

#!/usr/bin/env bash
# vw-backup.sh – eksport Vaultwarden (sejf osobisty
# + organizacja) do szyfrowanego 7z RR_MM_DD_VW.7z
# Działa na Linuksie i macOS.
set -euo pipefail
umask 077
cd "$(dirname "$0")"

ORG_ID="TU_WSTAW_ID_ORGANIZACJI"
ARCHIVE="$(date +%y_%m_%d)_VW.7z"
FILES=(osobisty.csv organizacja.csv)

# 7z (Linux, p7zip) albo 7zz (macOS, brew sevenzip)
SEVENZ="$(command -v 7z || command -v 7zz)" || {
  echo "Brak 7z/7zz w PATH." >&2
  exit 1
}

# shred na Linuksie, rm na macOS (brak shred,
# a na APFS nadpisywanie i tak nic nie daje)
wipe() {
  if command -v shred >/dev/null 2>&1; then
    shred -u -- "$@" 2>/dev/null || true
  else
    rm -f -- "$@"
  fi
}

cleanup() {
  wipe "${FILES[@]}"
  bw lock >/dev/null 2>&1 || true
}
trap cleanup EXIT

if [[ -e $ARCHIVE ]]; then
  echo "Plik $ARCHIVE już istnieje – przerywam." >&2
  exit 1
fi

# resztki po poprzednim uruchomieniu
wipe "${FILES[@]}"

# pyta o hasło główne
BW_SESSION="$(bw unlock --raw)"
export BW_SESSION

# bez sync eksport może być z nieaktualnego cache
bw sync >/dev/null
bw export --format csv --output osobisty.csv
bw export --organizationid "$ORG_ID" \
  --format csv --output organizacja.csv

# -p bez wartości: 7z pyta o hasło (nie trafia
# do historii ani ps); -mhe=on szyfruje listę plików
"$SEVENZ" a -t7z -mhe=on -p "$ARCHIVE" "${FILES[@]}"

echo "OK: $ARCHIVE"

Uruchomienie:

chmod 700 vw-backup.sh
./vw-backup.sh

Co robi skrypt i dlaczego

  • umask 077 sprawia, że pliki CSV i archiwum powstają z prawami 600.
  • trap cleanup EXIT usuwa pliki CSV i blokuje sejf również wtedy, gdy któryś krok zakończy się błędem.
  • Kontrola nazwy archiwum chroni przed dopisaniem plików do kopii z tego samego dnia.
  • Osobne przypisanie BW_SESSION ma znaczenie przy set -e. W wariancie export BW_SESSION=$(...) błędne hasło nie przerwałoby skryptu.
  • bw sync pobiera aktualny stan sejfu. CLI pracuje na lokalnej kopii danych, więc bez synchronizacji eksport może pominąć zmiany wprowadzone w przeglądarce lub na telefonie.
  • -p bez wartości powoduje, że 7z sam pyta o hasło. Hasło nie trafia więc do historii powłoki ani do listy procesów.
  • -mhe=on szyfruje nagłówki archiwum. Bez hasła nie zobaczysz nawet nazw plików.

Na koniec sprawdź wynik:

7z l 26_10_31_VW.7z

7z powinien najpierw zapytać o hasło, a dopiero potem pokazać oba pliki.

Uwaga: shred nadpisuje plik, ale na dyskach SSD nie gwarantuje fizycznego usunięcia danych. Realną ochroną pozostaje szyfrowanie całego dysku. Pliki CSV istnieją tylko przez kilka sekund między eksportem a pakowaniem.

Kopia zapasowa Vaultwarden na macOS

Pierwsza wersja skryptu nie działała na Macu. Zawiodły trzy elementy: macOS nie ma polecenia shred, Homebrew instaluje 7-Zip jako 7zz, a starsze wersje systemu nie obsługują readlink -f. Wersja powyżej uwzględnia wszystkie trzy różnice.

Przed pierwszym uruchomieniem zainstaluj narzędzia i skonfiguruj CLI. Konfiguracja z innego komputera nie przenosi się automatycznie:

brew install bitwarden-cli sevenzip
bw config server https://vault.twoja-domena.pl
bw login --apikey

Na macOS skrypt usuwa pliki CSV zwykłym rm. Na dysku APFS nadpisywanie i tak niczego nie gwarantuje. Dlatego upewnij się, że FileVault jest włączony.

Czego nie zawiera eksport CSV

Format CSV jest wygodny, ale niekompletny. Według dokumentacji Bitwardena karty płatnicze, tożsamości, passkeys i klucze SSH trafiają wyłącznie do eksportu JSON. Ponadto eksporty CSV i JSON nie obejmują załączników, kosza ani elementów Send.

Jeżeli kopia zapasowa Vaultwarden ma obejmować te typy danych, zmień w skrypcie format na JSON. Archiwum 7z i tak szyfruje zawartość, więc opcja encrypted_json nie jest tu potrzebna:

bw export --format json --output osobisty.json
bw export --organizationid "$ORG_ID" \
  --format json --output organizacja.json

Pamiętaj wtedy o zmianie nazw plików w tablicy FILES.

Załączniki sejfu osobistego Bitwarden pozwala pobrać w aplikacji webowej jako eksport .zip. Sprawdź, czy ta opcja jest dostępna w Twojej wersji panelu Vaultwarden.

Eksport to nie wszystko: kopia danych serwera

Kopia zapasowa Vaultwarden wykonana przez CLI chroni zawartość sejfów. Nie zastępuje jednak kopii samego serwera. Do odtworzenia całej instancji potrzebny jest katalog danych Vaultwarden: baza db.sqlite3, katalogi attachments i sends, klucze rsa_key* oraz plik config.json, jeśli istnieje. Działającą bazę kopiuj poleceniem sqlite3 db.sqlite3 ".backup kopia.sqlite3", a nie zwykłym cp. Szczegóły opisuje wiki projektu.

Najczęstsze pytania

Czy skrypt może działać z crona bez podawania haseł?

Technicznie tak. CLI przyjmuje hasło główne z pliku lub ze zmiennej środowiskowej (bw unlock --passwordfile, --passwordenv). Hasło archiwum trzeba by jednak również zapisać na dysku. Wtedy oba sekrety leżą obok kopii, którą mają chronić. Dlatego świadomie zostałem przy trybie interaktywnym.

Czy eksport organizacji wymaga specjalnych uprawnień?

Tak. Konto musi mieć prawo eksportu danych organizacji, zwykle rolę właściciela lub administratora. Bez tego drugie polecenie bw export zakończy się błędem.

Gdzie trzymać hasło do archiwum?

Poza sejfem, którego kopię chroni. Jeśli hasło archiwum zapiszesz tylko w Vaultwarden, po awarii serwera nie otworzysz żadnej kopii. Użyj długiego, unikalnego hasła i przechowuj je niezależnie, na przykład na papierze w bezpiecznym miejscu.

Podsumowanie

Kopia zapasowa Vaultwarden to teraz jedno polecenie i dwa hasła. Skrypt synchronizuje sejf, eksportuje dane, pakuje je do szyfrowanego archiwum i sprząta po sobie. Nazwy archiwów pozostały takie same, więc nowe kopie leżą obok starych.

A Ty jak zabezpieczasz kopię swojego sejfu haseł? Podziel się doświadczeniami w komentarzu.

Powiązane wpisy

Dokumentacja

G

Tagi: , , , ,

IPv6 i nawiasy kwadratowe w NFS

30 grudnia, 2023 | Brak Komentarzy | Kategoria: Linux, Porady
IPv6 i nawiasy kwadratowe w NFS

1. Wprowadzenie: Moje Doświadczenia z IPv6 i NFS w Debianie

W „karierze” administratora systemów Linux, często spotykałem się z wyzwaniami związanymi z implementacją IPv6. Szczególnie w ulubionym Debianie, gdzie zauważyłem, że konfiguracja udziałów NFS (Network File System) z użyciem IPv6 wymaga uwzględnienia pewnych szczegółów, zwłaszcza konieczności używania nawiasów kwadratowych wokół adresów IPv6.

2. Znaczenie Nawiasów Kwadratowych w Adresach IPv6

Podczas konfiguracji udziałów NFS adresy IPv6 muszą być umieszczone w nawiasach kwadratowych. Jest to kluczowe dla rozróżnienia portów i adresów, zwłaszcza gdy adres IPv6 zawiera segmenty, które mogą być pomylone z formatem adresu URL.

3. Konfiguracja Udziału NFS z Użyciem IPv6 – Krok po Kroku

Jak skonfigurować udział NFS z IPv6?

  • Edytujemy /etc/exports na serwerze NFS, dodając ścieżkę i adres, np.:
    /path/to/share [2001:db8::1](rw).
  • Na kliencie montujemu udział za pomocą:
    mount -t nfs [2001:db8::1]:/path/to/share /local/mountpoint.

4. Scenariusz Użycia: Kopie Zapasowe przez IPv6

Jednym z praktycznych zastosowań, które implementowałem, jest system kopii zapasowych wykorzystujący udział NFS dostępny przez IPv6. Jest to szczególnie przydatne, gdy serwer kopii zapasowych jest dostępny wyłącznie przez IPv6.

5. Implementacja Systemu Kopii Zapasowych

W tym scenariuszu używam oprogramowania do backupu, takiego jak rsync lub Bacula, konfigurując je do wysyłania danych na udział NFS dostępny przez IPv6. Pamiętajmy o umieszczeniu adresu IPv6 serwera w nawiasach kwadratowych, co jest kluczowe dla poprawnego rozpoznania adresu przez oprogramowanie.

6. Podsumowanie

Podsumowując, użycie nawiasów kwadratowych w adresach IPv6 jest niezbędne przy konfiguracji udziałów NFS w Debianie. To prosta, ale istotna praktyka, która zapewnia prawidłową komunikację w sieciach IPv6 i pozwala na efektywne wykorzystanie technologii w takich zastosowaniach jak systemy kopii zapasowych.

G

Tagi: , , ,

Kopie zapasowe VMware

31 sierpnia, 2022 | Brak Komentarzy | Kategoria: Porady
Kopie zapasowe VMware

Kopie zapasowe VMware dla maszyn wirtualnych były wielokrotnie poruszane na naszym blogu. Generalnie polecam narzędzie XSIBackup. Ostatnio pojawiły się nowsze płatne wersje ale na szczęście zawsze można skorzystać z wydania pod nazwą Classic.

Przygotowanie całego mechanizmu kopii to jedno, ale proces odzyskiwania danych po awarii to zupełnie inna sprawa. Dawno temu VMware opublikował wygodne narzędzie dla Windows o nazwie VMware Converter. Można go użyć w celu odtworzenia maszyny wirtualnej na wskazanym serwerze. Nietstety narzędzie to nie jest już wspierane od kilku lat i w związku z tym mogą pojawić kłopoty przy odzyskiwaniu danych dla nowszych wersji ESXi. Czy komunikaty o błędach Converetera są powodem do zmartwień? W pewnym sensie tak. Jednak na szczęście istnieje ręczna, dosyć prosta metoda odzyskania zarchiwizowanej maszyny wirtualnej.

W plikach skopiowanych podczas archiwizacji XSIBackup powinna znajdować się konfiguracja – szukamy nazwy z rozszerzeniem vmx. Jeśli tak jest, to kopiujemy wszystkie pliki do jednego katalogu (np. z nazwą naszej maszyny) na serwerze VMware. Można w tym celu wykorzystać narzędzie Datastore browser. Następnie zaznaczamy plik vmx i prawym klawiszem myszki wybieramy z menu opcje Register VM. O ile nie wykonywaliśmy żadnych migawek maszyny, które również są archwizowane to po tej operacji maszyna powinna być już dostępna do uruchomienia.

Co zrobić jeśli jednak mamy zapisane migawki? W takim przypadku powinniśmy zatrzymać maszynę wirtualną a następnie korzystając z menu Actions/Snapshots wybrać opcję Consolidate Disks. Niestety stracimy nasze migawki ale odzyskamy wewnętrzny spokój i równowagę po przywróceniu maszyny wirtualnej do życia, a przecież o to właśnie chodzi. 😉

MG

Tagi: , ,

Kopie zapasowe Docker

3 sierpnia, 2022 | Brak Komentarzy | Kategoria: Bez kategorii, Linux, MacOS, Porady, Windows
Kopie zapasowe Docker

Ten temat pojawiał się wielokrotnie we wpisach. Chodzi oczywiście o kopie zapasowe. Ludzie dzielą się na dwie kategorie tych, którzy je robią i tych, którzy je będą robili (truizm, ale trzeba go powtarzać do znudzenia). Tym razem, ponieważ od jakiegoś czasu bardzo popularne są rozwiązania oparte o konteneryzację, parę słów jak to zrobić gdy używamy środowiska Docker.

Oczywiście metodę, o której będzie za chwilę można również stosować np. do migracji całych kontenerów na nowe serwery.

Cała procedura składa się z kilku dosyć prostych kroków. Jedynym wymaganiem jest posiadanie dostępu w wiersza poleceń (konsola). Inna sprawa to mała sugestia, że najlepiej będzie skorzystać ze środowiska Linux (Debian, Ubuntu itp.) do budowy swojego serwera. Jednak w przypadku Windowsów również wszystko powinno działać.

Krok pierwszy to zatrzymanie kontenera, dla którego będziemy tworzyć kopię zapasową:

docker stop nazwa_kontenera

Jeżeli nie wiemy jakiej nazwy użyć lub po prostu otrzymujemy komunikat o błędzie wystarczy sprawdzić wszystkie dostępne kontenery:

docker container ls

W drugim kroku tworzymy obraz naszego kontenera:

docker commit nazwa_kontenera nazwa_kontenera

Ostatni parametr to tak naprawdę nazwa obrazu ale dla uproszczenia przyjmijmy, że jest ona taka sama jak nazwa kontenera.

Trzeci krok to zapisanie obrazu do pliku.

docker save nazwa_kontenera

W tym miejscu należy wspomnieć, że do tego momentu udało się zapisać stan kontenera. Jeśli instalacje, dla których robimy kopie mają zdefiniowane zewnętrzne wolumeny to należy skopiować ich zawartość oddzielnie. Generalnie można to zrobić ręcznie, ale dużo wygodniej będzie skorzystać z gotowego rozwiązania. Warto polecić skrypt docker-volumes.sh. Za jego pomocą dosyć łatwo można zapisać wszystkie stałe dane do jednego archiwum:

docker-volumes.sh nazwa_kontenera \ 
save nazwa_kontenera_wolumeny.tar.gz

Mając kopie zapasową w postaci dwóch plików tj. obrazu kontenera oraz wolumenów jesteśmy zabezpieczeni. Jeśli chcielibyśmy przenieść dane na inne sewery wystarczy skopiować je do nowej lokalizacji.

Ostatecznie na nowym serwerze, po przygotowaniu środowiska Docker, wykonujemy trzy polecenia.

Tworzymy kontener z wykorzystaniem skopiowanego obrazu:

docker create --name nazwa_kontenera \
{zestaw_opcji_uruchomieniowych} nazwa_kontenera

Przywracamy wolumeny:

docker-volumes.sh nazwa_kontenera load nazwa_kontenera_wolumeny.tar.gz

Uruchamiamy kopie kontenera:

docker start nazwa_kontenera

Przy odrobinie szczęścia, w tym momencie powinniśmy cieszyć się kolejną, nową instancją naszej usługi.

MG

Tagi: , ,

xsibackup – ręczne kopie zapasowe VMware ESXi

26 stycznia, 2019 | Brak Komentarzy | Kategoria: Linux, Porady, Windows

Wirtualizacja jest obecnie bardzo modnym i nośnym tematem. Oferta dotycząca rozmaitych wersji maszyn wirtualnych oferowanych w ramach usług dostępnych u dostawców jest olbrzymia. Oprócz możliwości wykupienia takiej usługi – z czego przyznam sam korzystam i mogę polecić np. DigitalOcean – istnieje wiele rozwiązań dla użytkowników końcowych, którzy sami chcą się pobawić w administrowanie. W końcu będzie to zawsze jeszcze jedna ciekawa umiejętność, a jak za chwilę postaram się wyjasnić może przydać się w różnych scenariuszach użycia. Rozwiązania pokroju Oracle Virtualbox, chyba najbardziej popularne i łatwe w utrzymaniu, wprowadzają łagodnie w świat wirtualizacji. Potem z reguły przychodzi kolej na rozwiązania niższego poziomu jak VMware ESXi czy KVM. Mowa tu o korzystaniu z własnych hostów maszyn wirtualnych. Wbrew pozorom nie jest to specjalnie trudne i jeżeli tylko korzystamy ze standardowego sprzętu serwerowego to instalacja np. VMware ESXi jest praktycznie bezbolesna.

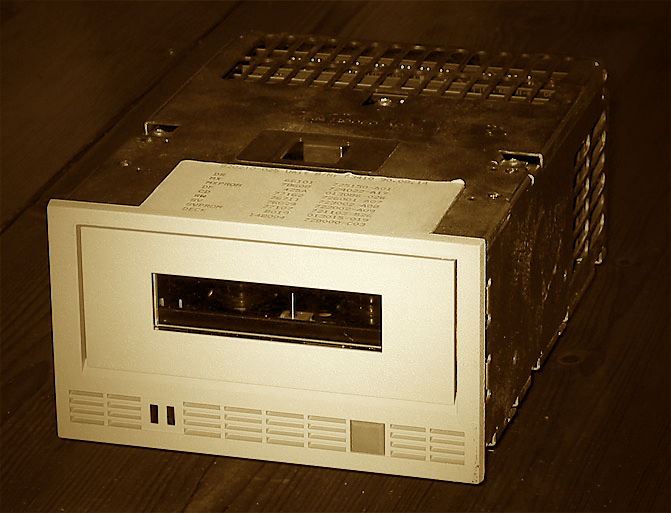
Zapisz kopie xsibackup na streamerze.

W momencie gdy jesteśmy już dumnymi właścicielami małej wirtualnej infrastruktury, nawet jeżeli jest to tylko jeden serwer, możemy rozpocząć budowanie własnej sieci serwerów wirtualnych. Zazwyczaj zaczyna się od jednej jednostki ale apetyt bardzo szybko rośnie w miarę jedzenia i z czasem przybywa nam umiętności, pewności siebie oraz oczywiście nowych węzłów sieciowych. Przenoszenie na platformę wirtualizacyjną serwerów Windows czy Linux jest bardzo łatwe. Naprawdę warto zastanowić się nad tego typu wdrożeniami bo można szybko przekonać się o zaletach rozwiązania. Jednak jak zwykle wraz ze wzrostem apetytu zaczynamy również odkrywać powoli minusy. W moim przypadku był to brak pewnych narzędzi administracyjnych wynikający głównie z korzystania z wersji niekomercyjnej VMware ESXi. Mowa tu o automatycznych kopiach zapasowych maszyn wirtualnych, które byłyby wykonywane w locie, czyli bez zatrzymywania usług.

Krótkie badanie rynku komercyjnych aplikacji do wykonywania kopii zapasowych VMware pokazało, że rozwiązań jest bardzo dużo. Niestety większość ma istotne ograniczenia w wersjach demonstracyjnych. Inne z kolei nie integrują się bezpośrednio z hostem maszyn wirtulanych i wymagają stosowania zewnętrznego komputera z aplikacją. Po jakimś czasie trafiłem w końcu na stronę 33hops.com, gdzie znalazłem ciekawe narzędzie o nazwie xsibackup. Był to strzał w dziesiątke, okazało się bowiem, że istnieje nieodpłatne narzędzie linii poleceń, które pzowala wykonać ręcznie i automatycznie kopie zapasowe.

Na wspomnianej stronie, po podaniu adresu email, możemy pobrać oprogramowanie do instalacji. W wiadomości od producenta otrzymamy również bardzo precyzyjną i szczegółową instrukcję instalacji. Koniec końców cały proces sprowadza się do przygotowania komendy (narzędzia), która pozwoli na zrzucenie ad-hoc kopii maszyn wirtulanych. Ogólnie mówiąc, po zalogowaniu się na konsolę naszego hosta możemy rozpocząć całą zabawę. Poniżej zamieściłem dwa przykłady użycia bazując na własnych doświadczeniach.

Aby sprawdzić poprawność instalacji i wykonać test kopiowania maszyn wirtualnych użyjemy polecenia:

./xsibackup --backup-point=/vmfs/volumes/backup /
--backup-type=running --test-mode=true

Opcja test-mode=true spowoduje, że żadne kopie nie zostaną uruchomione, ale będziemy mogli przetestować poprawność polecenia. Z kolei backup-type=running mówi, że skopiowane mają zostać wszystkie uruchomione maszyny wirtualne – bez ich zatrzymywania (sic!).

Drugim poleceniem jest już komenda służąca wykonania kopii wybranej maszyny:

./xsibackup --backup-point=/vmfs/volumes/backup /
--backup-vms="Nazwa maszyny wirtualnej" /
--backup-type=custom

W tym przypadku warto zwrócić uwagę, że ponieważ wskazujemy, którą maszynę wirtualną chcemy skopiować to należy użyć opcji backup-type=custom.

Mam nadzieję, że te dwa przykładowe polecenia zachęcą zainteresowanych do korzystania i używania kopii zapasowych za pomocą xsibackup. W końcu kopie zapasowe to podstawa i nie trzeba chyba tego nikomu powtarzać 😉 .

MG

Tagi: , , , ,